Cerebras 晶圓級 AI 漫畫小教室:為什麼把處理器做到整片晶圓?
十二張漫畫從資料搬移、reticle stitching 與缺陷容忍,講到片上 SRAM、dataflow、CSoft、CS-4、prefill/decode,以及 Cerebras、GPU、Taalas 的架構取捨。
AI TECHNOLOGY
用漫畫與工程拆解 LLM、Token、KV Cache、AI 推論、記憶體瓶頸與加速器架構。
十二張漫畫從資料搬移、reticle stitching 與缺陷容忍,講到片上 SRAM、dataflow、CSoft、CS-4、prefill/decode,以及 Cerebras、GPU、Taalas 的架構取捨。
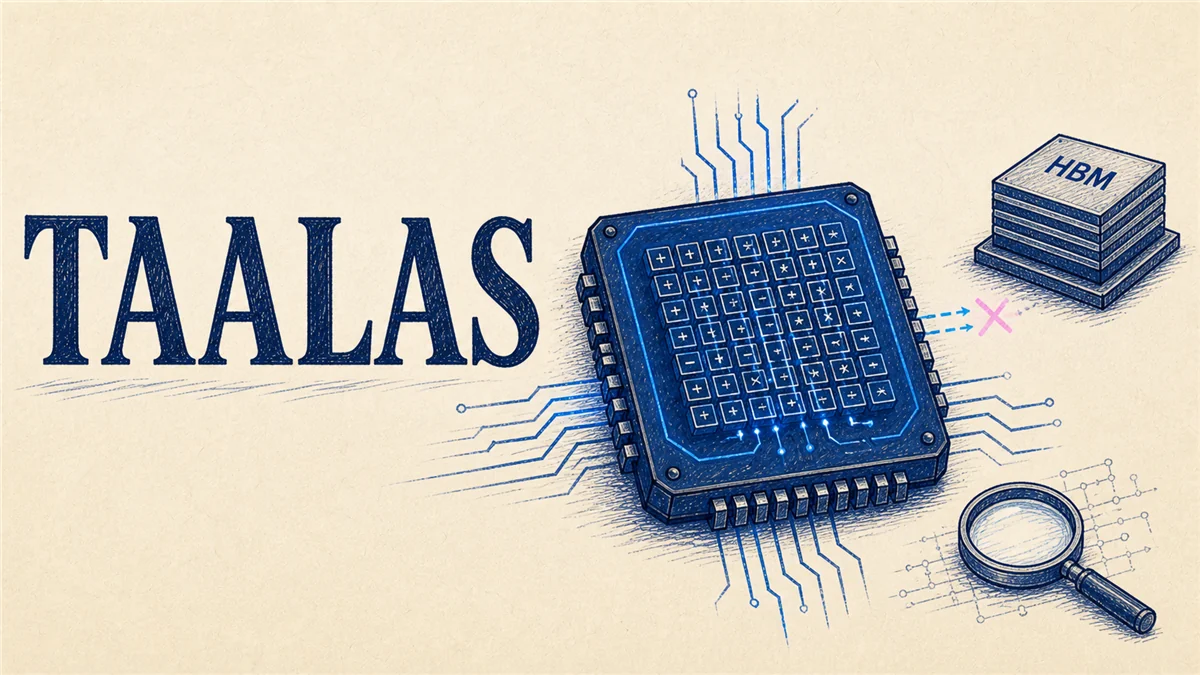
十張漫畫從 HBM 搬移瓶頸講到 4-bit 候選表、one-hot 選路、跨維度累加與 HC1 的專用化代價。本課以教室教學模型拆解硬連線推論的工程直覺,並標明官方數字的測試邊界。
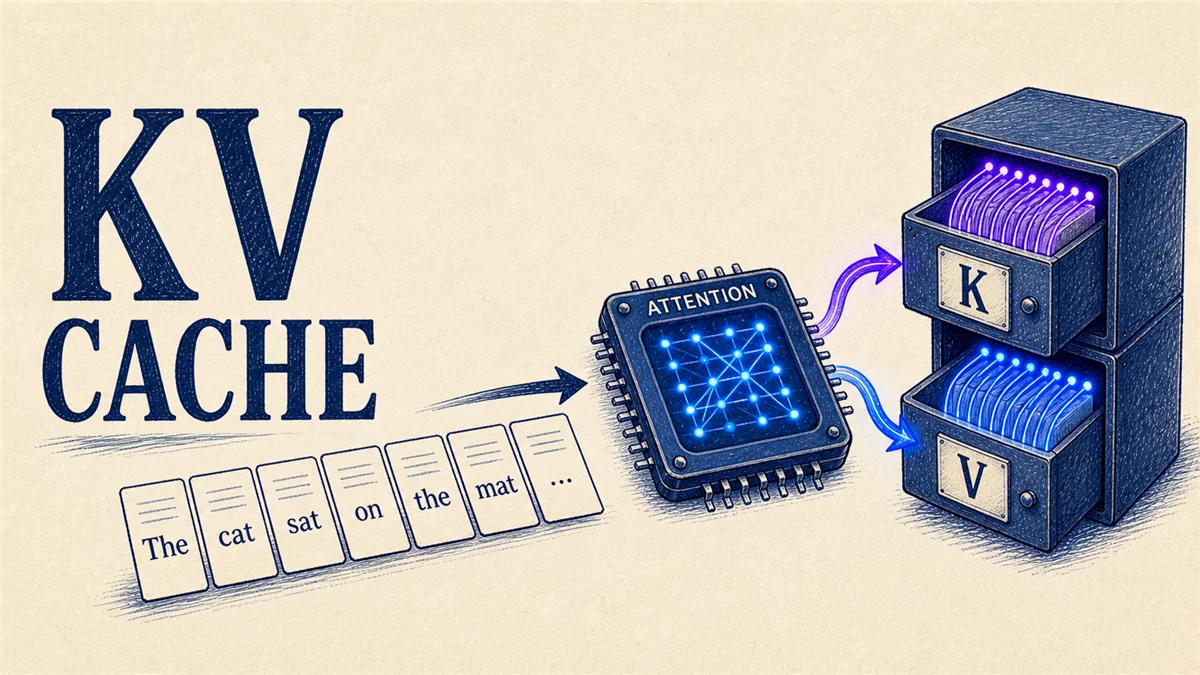
用「小美養貓」這句例子,拆開 token、位置資訊、Q/K/V、attention、residual connection 與 KV cache,說清楚自回歸 LLM 每產生一個新 token 時,哪些資料能沿用、哪些工作仍得重做。
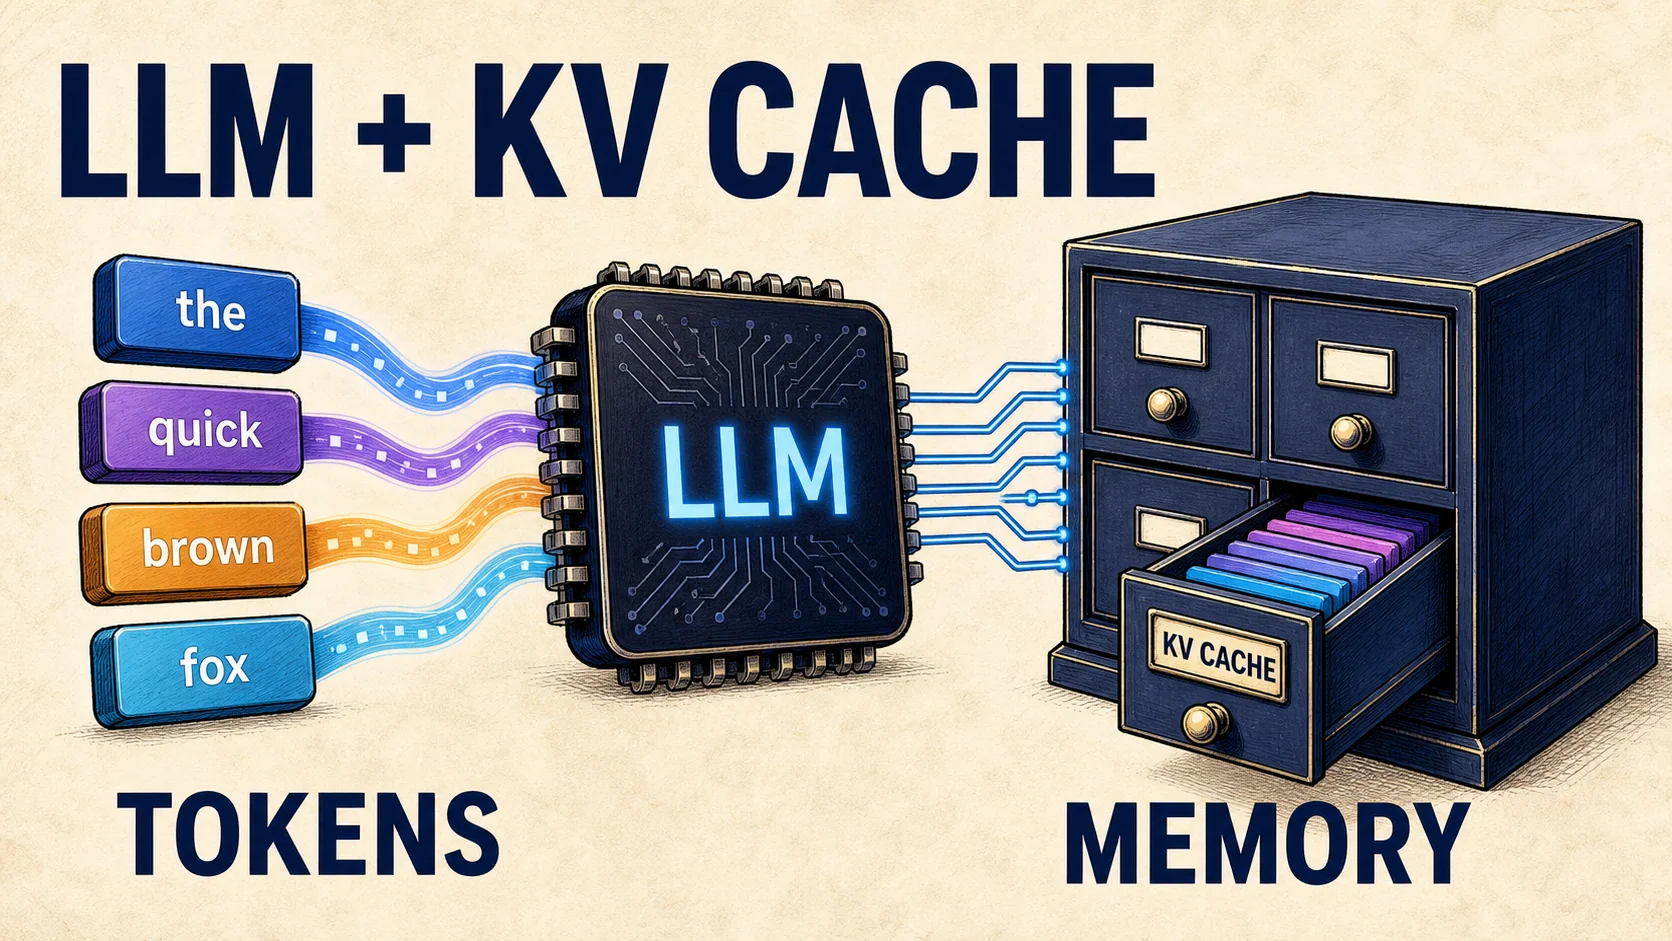
這篇先用六張漫畫回答一個問題:LLM 為什麼能一句一句接出像樣的回答?我們會從「猜下一個字」開始,慢慢帶到 token、向量、K/V 筆記與 KV Cache,最後再看為什麼對話越長,AI 系統越容易被記憶體與資料搬移拖慢。